01
ETL
Extração, Transformação e Carga
Pipelines que extraem dados de várias fontes, tratam conforme as regras do negócio e carregam no destino com integração e qualidade.
PentahoSpark
Engenharia de Dados
ETL, Data Lake e Data Warehouse para uma base única, confiável e pronta para BI e IA.
O que entregamos
ERPs, CRM, APIs, planilhas e bancos reunidos em um só lugar.
Histórico completo guardado de forma escalável e econômica.
Fatos e dimensões modelados para consultas rápidas no BI.
Regras de qualidade, versionamento e controle de acesso aos dados.
Especialidades
Extração, Transformação e Carga
Pipelines que extraem dados de várias fontes, tratam conforme as regras do negócio e carregam no destino com integração e qualidade.
Armazenamento em escala
Grandes volumes de dados brutos guardados de forma escalável e econômica, prontos para análises avançadas e machine learning.
Dados organizados para decisão
Dados de diferentes fontes centralizados em um repositório organizado, com consultas rápidas para decisões estratégicas.
Arquitetura
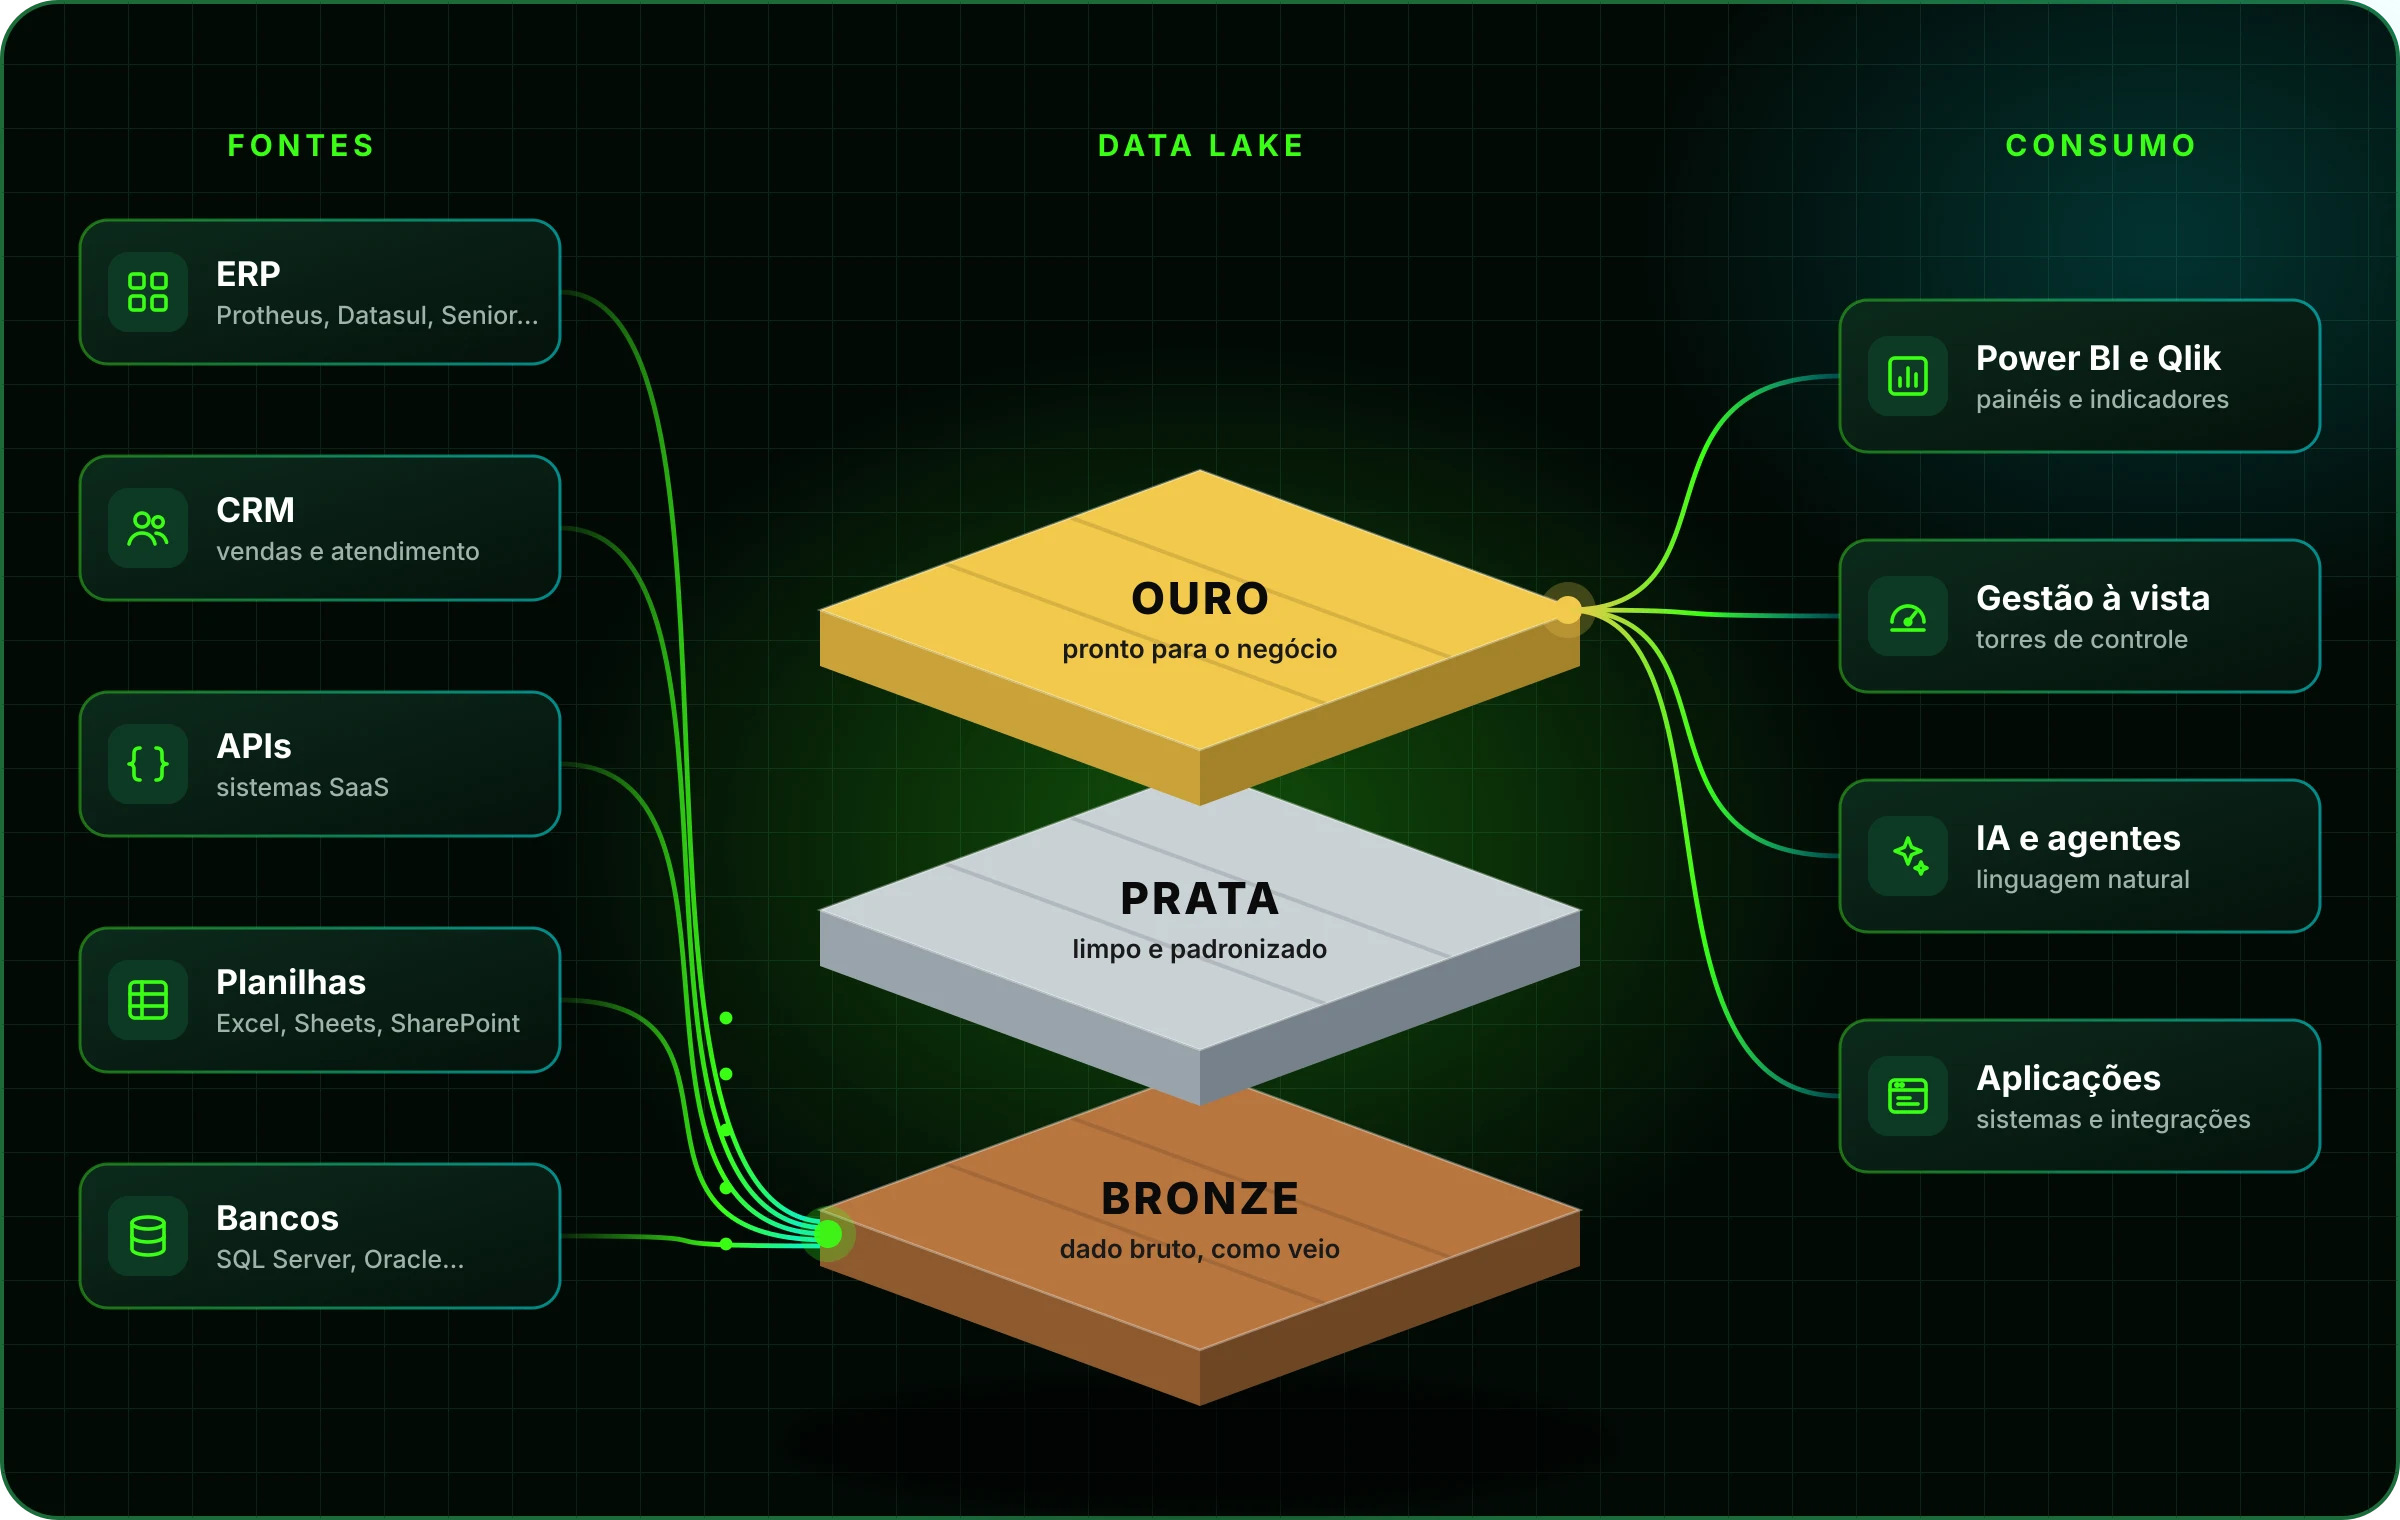
A arquitetura medalhão separa o que chegou do que foi tratado e do que o negócio consome. Cada camada tem um papel claro.
Ingestão
Dados extraídos das fontes como vieram, com carga incremental: só entra o que mudou desde a última execução.
Tratamento
Dados limpos, padronizados e sem duplicidade, atualizados por MERGE e validados por regras de qualidade.
Modelo de negócio
Modelo dimensional com fatos e dimensões por área, pronto para painéis, relatórios e agentes de IA.
Plataformas
Escolhemos a plataforma pelo seu cenário de custo, volume e equipe, não o contrário.
 Nuvem
Lakehouse, pipelines, notebooks e dataflows integrados ao Power BI em uma só plataforma.
 Nuvem
Pipelines e notebooks Spark, com runtime de integração que alcança os bancos dentro da sua rede.
 Nuvem
Lakehouse em Delta Lake com otimização de tabelas, rotinas de limpeza e qualidade de dados em escala.
 Nuvem
Data warehouse com zona de pouso e procedures que levam o dado bruto até o modelo final.
 On-premises
Lake no seu servidor com Spark, Delta Lake, MinIO e Airflow: controle total, sem custo de capacidade em nuvem.
 Híbrido
ETL visual para dezenas de fontes, com versionamento e deploy automatizado.
Fontes
Por que funciona
Em vez de recarregar tudo todo dia, levamos só o que mudou. A carga fica mais rápida, mais barata e cada versão do dado fica registrada.
# CDC: só o que mudou desde a última cargadf = (spark.read.jdbc(url, "erp.pedidos").where(col("updated_at") > checkpoint))df.write.format("delta").mode("append") \.save("s3a://lake/bronze/pedidos")
-- bronze → prata, só o que mudouMERGE INTO prata.pedidos pUSING bronze.pedidos_cdc cON p.id = c.idWHEN MATCHED THEN UPDATE SET *WHEN NOT MATCHED THEN INSERT *
# orquestração: roda de hora em hora@dag(schedule="@hourly")def vendas():extrair = spark_job("extrair_cdc")tratar = spark_job("bronze_para_prata")modelar = spark_job("prata_para_ouro")extrair >> tratar >> modelar
Cases
Por que importa
Um agente de IA só responde bem se o dado estiver organizado. Com a camada ouro modelada, a IA navega um modelo de negócio pronto e auditável, em vez de adivinhar.
O que você ganha
Como entregamos
Levantamos sistemas, volumes e regras de negócio, e definimos a plataforma que faz sentido.
Ingestão, tratamento e modelo de negócio entregues por área, já alimentando os primeiros painéis.
Monitoramos as cargas, cuidamos da qualidade e incluímos novas fontes conforme o negócio cresce.