01
ETL
Extracción, Transformación y Carga
Pipelines que extraen datos de varias fuentes, los tratan según las reglas del negocio y los cargan en el destino con integración y calidad.
PentahoSpark
Inicio / Soluciones / Datos
Ingeniería de Datos
ETL, Data Lake y Data Warehouse para una base única, confiable y lista para BI e IA.
Lo que entregamos
ERPs, CRM, APIs, planillas y bases de datos reunidos en un solo lugar.
Historial completo guardado de forma escalable y económica.
Hechos y dimensiones modelados para consultas rápidas en el BI.
Reglas de calidad, versionado y control de acceso a los datos.
Especialidades
Extracción, Transformación y Carga
Pipelines que extraen datos de varias fuentes, los tratan según las reglas del negocio y los cargan en el destino con integración y calidad.
Almacenamiento a escala
Grandes volúmenes de datos brutos guardados de forma escalable y económica, listos para análisis avanzados y machine learning.
Datos organizados para decidir
Datos de diferentes fuentes centralizados en un repositorio organizado, con consultas rápidas para decisiones estratégicas.
Arquitectura
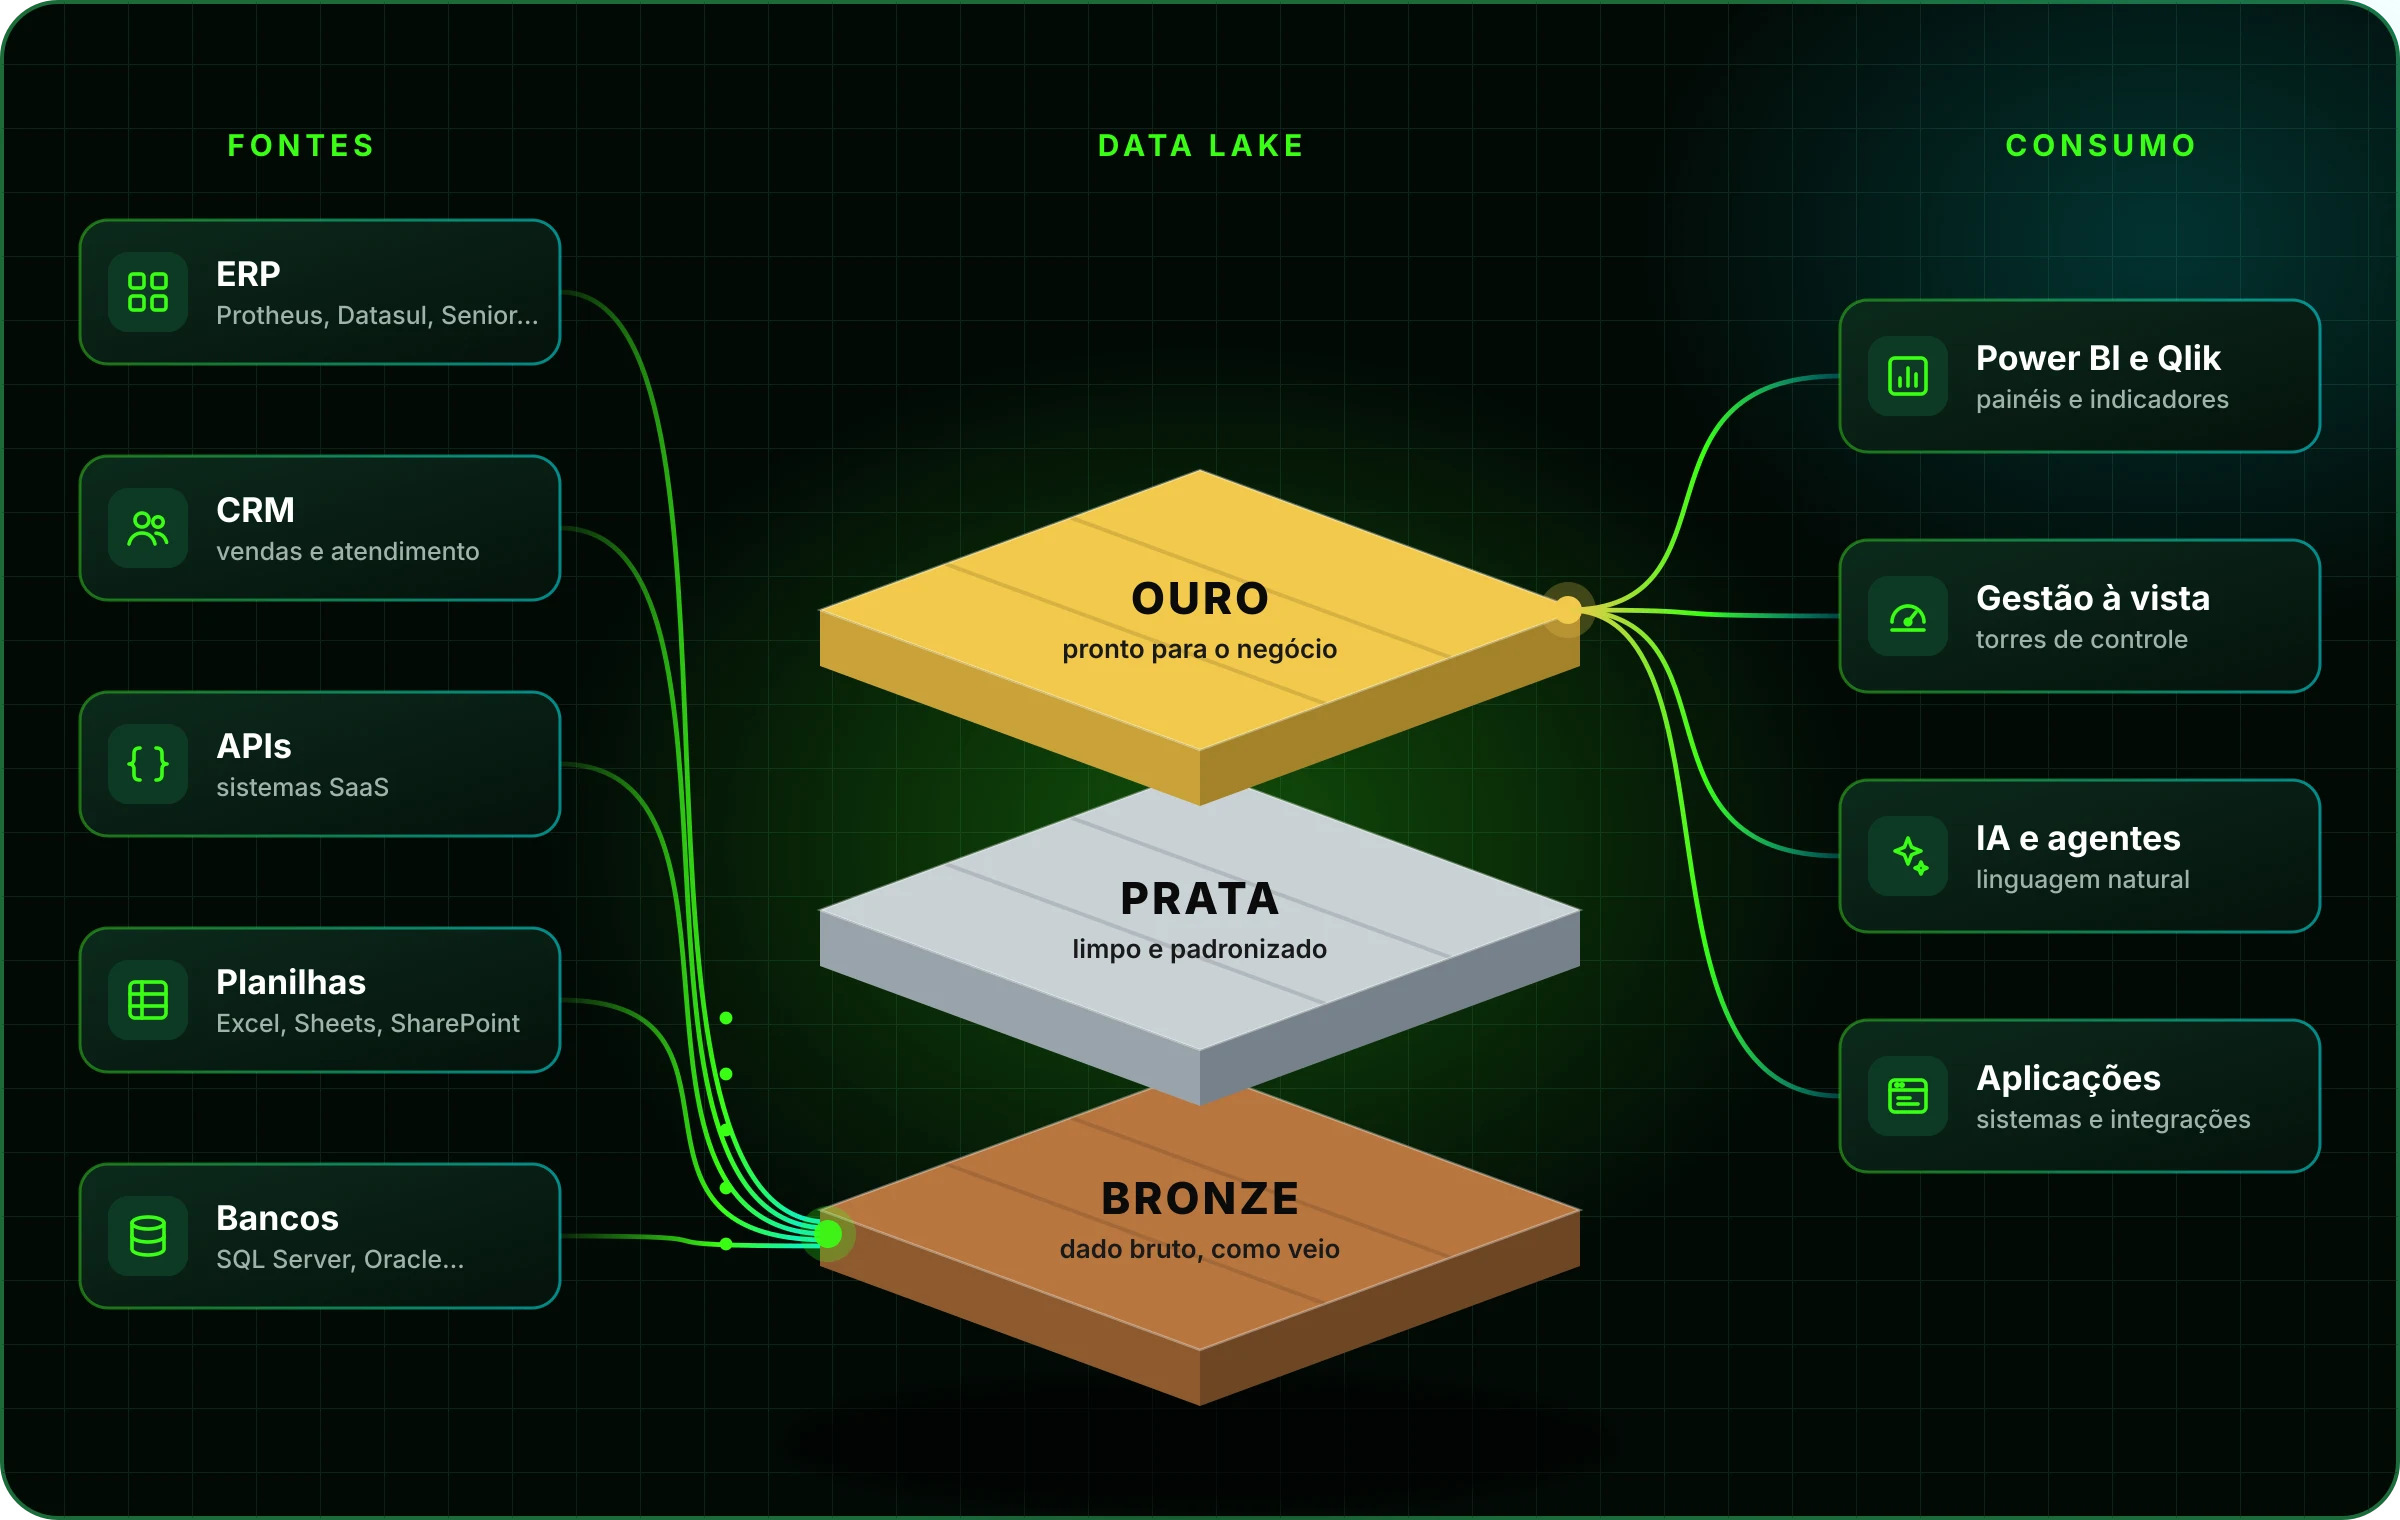
La arquitectura medallón separa lo que llegó de lo que fue tratado y de lo que consume el negocio. Cada capa tiene un papel claro.
Ingesta
Datos extraídos de las fuentes tal como vinieron, con carga incremental: solo entra lo que cambió desde la última ejecución.
Tratamiento
Datos limpios, estandarizados y sin duplicados, actualizados por MERGE y validados por reglas de calidad.
Modelo de negocio
Modelo dimensional con hechos y dimensiones por área, listo para paneles, informes y agentes de IA.
Plataformas
Elegimos la plataforma según su escenario de costo, volumen y equipo, no al revés.
 Nube
Lakehouse, pipelines, notebooks y dataflows integrados a Power BI en una sola plataforma.
 Nube
Pipelines y notebooks Spark, con runtime de integración que alcanza las bases dentro de su red.
 Nube
Lakehouse en Delta Lake con optimización de tablas, rutinas de limpieza y calidad de datos a escala.
 Nube
Data warehouse con zona de aterrizaje y procedures que llevan el dato bruto hasta el modelo final.
 On-premises
Lake en su servidor con Spark, Delta Lake, MinIO y Airflow: control total, sin costo de capacidad en la nube.
 Híbrido
ETL visual para decenas de fuentes, con versionado y deploy automatizado.
Fuentes
Por qué funciona
En lugar de recargar todo cada día, llevamos solo lo que cambió. La carga es más rápida, más barata y cada versión del dato queda registrada.
# CDC: só o que mudou desde a última cargadf = (spark.read.jdbc(url, "erp.pedidos").where(col("updated_at") > checkpoint))df.write.format("delta").mode("append") \.save("s3a://lake/bronze/pedidos")
-- bronze → prata, só o que mudouMERGE INTO prata.pedidos pUSING bronze.pedidos_cdc cON p.id = c.idWHEN MATCHED THEN UPDATE SET *WHEN NOT MATCHED THEN INSERT *
# orquestração: roda de hora em hora@dag(schedule="@hourly")def vendas():extrair = spark_job("extrair_cdc")tratar = spark_job("bronze_para_prata")modelar = spark_job("prata_para_ouro")extrair >> tratar >> modelar
Casos
Por qué importa
Un agente de IA solo responde bien si el dato está organizado. Con la capa oro modelada, la IA navega un modelo de negocio listo y auditable, en lugar de adivinar.
Lo que usted gana
Cómo entregamos
Relevamos sistemas, volúmenes y reglas de negocio, y definimos la plataforma que tiene sentido.
Ingesta, tratamiento y modelo de negocio entregados por área, ya alimentando los primeros paneles.
Monitoreamos las cargas, cuidamos la calidad e incluimos nuevas fuentes a medida que el negocio crece.